行き詰まりを、越える。
以前のAI利用では解決に至らなかった案件で、調査・修正・検証が先へ進む。
LMR / FIELD OBSERVATION 株式会社 回線媒体研究所LINE MEDIA RESEARCH
PRIVATE AI / BUILT FOR YOUR R&D
LMRの開発現場で起きたこと。
そんなケースを、知っていましたか?
難しい案件に、考える時間と検証する余力を。
専用GPU・開発知識・実行ツールを組み合わせ、
クラウドAIで停滞していた開発を、次の段階へ。
LMRの自社運用での実感に基づく表現です。成果は対象業務・モデル・設定に依存し、全タスクでの優位性を示すものではありません。
測りたいのは、仕事がどこまで進むか。
タスク完了率 / 人の手戻り / 検証までの時間LMRが注目したのは、会話の巧さよりも、実際の開発がどこまで進むか。自社の運用から、こんな変化を感じています。
以前のAI利用では解決に至らなかった案件で、調査・修正・検証が先へ進む。
LMR / FIELD OBSERVATIONクローラー開発では、取得漏れや処理の抜けなど、以前は見逃していた論点を発見。
LMR / FIELD OBSERVATION過去の会話や他案件のノウハウを検索し、明示しきれなかった条件を補える可能性。
LMR / FIELD OBSERVATION代表者の運用報告に基づく観察です。原因を特定する統制比較や、性能倍率の測定結果ではありません。
定額の共有サービスには、計算原価・待ち時間・利用者全体の処理量を両立させる必要があります。自社設備では、重要な一つの案件へ配分する計算と時間を、自分たちで決められます。
SHARED SERVICE
利用者全体の需要と費用を見ながら、計算資源を配分する。
DEDICATED INFRASTRUCTURE
業務の優先順位に合わせて、推論・探索・検証を続ける。
比べるべきは、案件に継続して使える
「計算・試行・検証の予算」。
事業構造からの考察と構成概念です。各社のGPU割当量は非公開であり、利用者数で割った平均と1回の推論に使われるGPU規模は同じではありません。専用契約等は条件が異なります。[R4]
同じモデルでも、速度・費用・応答の深さを調整する設定があります。すべてのタスクで、最大限の推論と検証を行うことが既定とは限りません。
OPENAI / REASONING EFFORT
公式API資料は、低いeffortが速度と少ないトークン使用を優先することを説明しています。高い推論設定も選択できます。
公式資料を読む ↗ANTHROPIC / EFFORT
公式API資料は、コスト・速度と徹底度の調整を説明。低いeffortによる能力への影響や、ツール呼び出しの減少にも触れています。
公式資料を読む ↗元PDFの公式資料確認日:2026年11月16日。APIの公開仕様であり、各アプリの内部設定や個別の失敗原因を証明するものではありません。計算と品質のトレードオフを示す資料です。
仮説を試す。失敗を読む。別の方法を調べる。修正して、回帰テストまで進む。
難しい開発では、この反復が成果を左右します。
時間・トークン・反復上限
別案の調査・ツール実行
修正・再試験・完了判定
原因候補だけ提示
一部修正・未検証のまま終了
別案を検証し、根拠付きで修正
再試験と完了判定へ
「もう一度調べる」「別案を試す」「修正後に確かめる」。専用GPUに、実行と評価の仕組みを組み合わせます。
計算・実行予算の不足は、未解決を生む要因になり得ます。ただし、モデル能力・指示・知識・ツール・評価方法も結果を左右します。長い推論や大きな設備だけで、性能向上を保証するものではありません。[R1–R3]
「考える」「調べる」「覚えている」「試して直す」。
この一連の仕事を、ひとつの環境で回す。
モデル × 計算環境
× 知識 × 実行・検証
自社の優先順位で推論時間と並列度を配分。
過去の判断・失敗・修正理由をRAGで参照。
コード・Web・画像・テストにアクセス。
実行結果を確認し、次の修正に反映。
自分たちの研究を、どこまで進めるか。
その判断と実行環境を、自社の手元へ。
外部AIサービスの一律の利用制限や利用枠に、研究計画を左右されにくい。
モデル、ツール、実行権限、更新時期を、自社の研究目的に合わせて設計。
ローカル推論のトークン従量課金なし。設備・電力・運用費の中で、反復の予算を設計。
自由度とは、運用方針を自社で決められること。モデルやソフトウェアの仕様、法令・契約上の条件は残ります。外部APIを併用する場合、その利用料金は別途発生します。
Web収集、保守開発、画像理解、継続改良。そして、AI自動ペネトレーションテスト。共通のAI基盤から、業務ごとのシステムへ。
PENTEST / DEVELOPMENT EXAMPLE
自社システムや、診断を依頼された環境を対象に、試験計画・実行・証拠整理・修正支援をつなぐ。仮説を立て、検証し、直した後にもう一度確かめます。
構築するシステムの提案例です。各テーマの提供機能は、要件に合わせて設計します。
WORKFLOW / CONCEPT
試験記録 / 根拠付きレポート / 修正提案 / 再試験結果
LMRの設備を基にした構成。導入先では、対象モデルと同時利用数に合わせて設計します。
ランチャー / IDE / CLI
認証・接続制御
管理 / 実行通信
DELL / POWEREDGE XE9780
4基をローカルGLM-5.2に割当
残る4基の用途は、この図では規定していません。
コード / モデル / RAG
ログ / 検証成果物
VLM / 検索 / テスト実行
配置はワークロードで決定
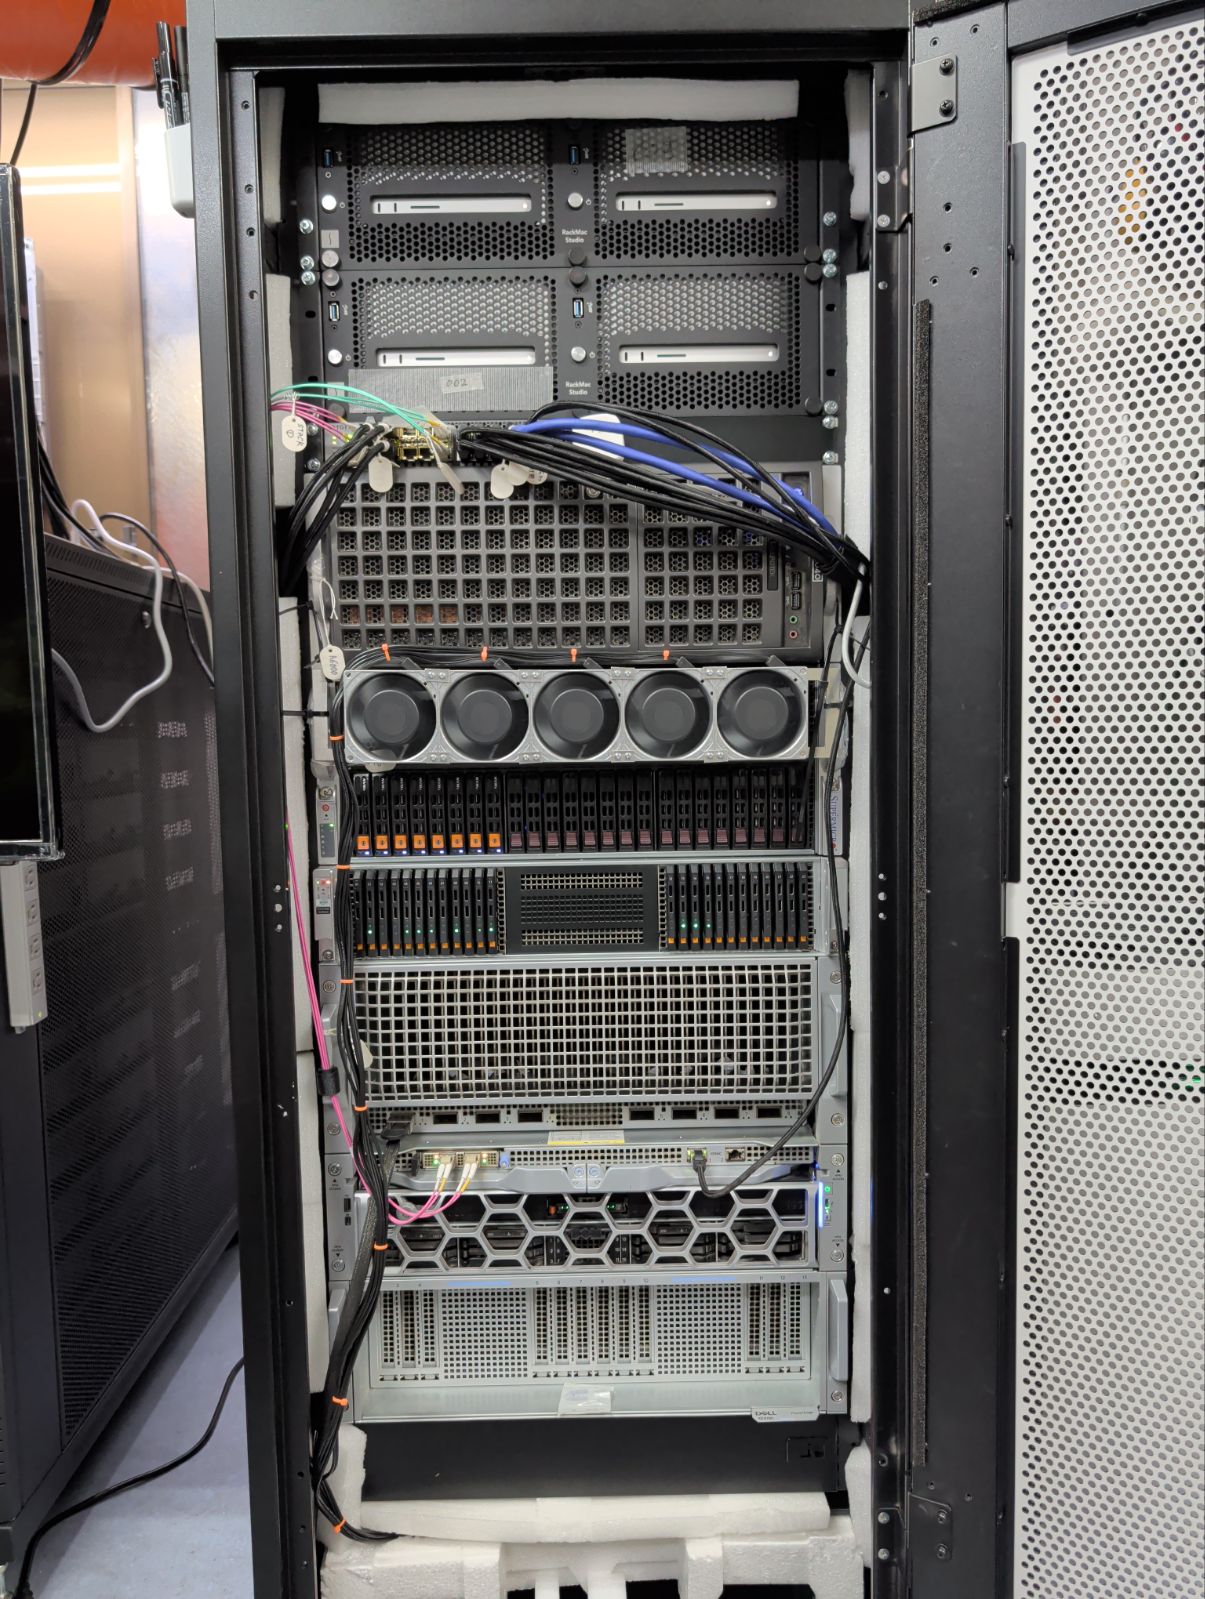
A100 × 8 / A6000 × 2 / Mac Studio M3 Ultra 512GB × 4
元PDFに記載された設備に基づく模式図です。実配線・全ソフトの配置を示すものではありません。Dell等との提携・認定・販売契約を示す表示ではありません。
モデルと実行環境、知識の保管先を接続。必要な情報を検索し、ツールで確かめ、その結果を次の推論へ返します。
01 / WORKSPACE
プロジェクト・設定を選択
計画 / ツール呼び出し / 結果確認
現在の操作・実行の入口
02 / LOCAL INTELLIGENCE
GLM-5.2 / B300 4基
必要な機能を呼び出し、
観測結果を次の推論へ返す
03 / KNOWLEDGE & TOOLS
過去の会話 / ノウハウ / 根拠
画像・画面の理解 / Web収集
VLMはMCP経由で連携
Git / CI・テスト環境 / ジョブ管理 / 権限・承認 / 監視・監査ログ / 検証済み知見のRAG登録
現在の運用要素に基づく論理構成です。API変換層やRAGの検索経路、第三者製ソフトの互換性・利用条件は提供構成ごとに確認し、実行層を交換できる形で設計します。
「何を確認すべきか」「どこで失敗したか」「なぜ、その設計か」。過去の対話から取り出した知識を、今の作業に使える形で届ける。モデルの重みを更新しなくても、参照する経験は育てられます。
指示・修正理由
成功と失敗の経緯
適用条件・根拠
機密区分・有効期限
現在の案件に合う
知見を絞り込む
成果を確かめ、
使える知見を更新
知識を詰め込むだけでなく、「どの案件に、いつ使うか」まで設計する。
24時間の運用を見据え、試行・評価・再実行を自動化する。AIに「良くしておいて」と任せる前に、良くなったことを確かめる基準をつくります。
改善が止まれば、理由を残して人に引き継ぎます。
固定した検証用URLで取得率を比較。サイト別の負荷上限と、既存機能の回帰テストを維持します。
目標・予算・停止条件
失敗記録を調査
候補を実装
採用 / 再試行 / 停止
固定テストで確認
01 → 02 → 03 → 04 → 次の仮説へ
本番反映は設定した承認条件に従います。モデル名だけでなく、知識・ツール・作業予算を揃えて比較。いま止まっている案件を、評価の出発点にします。
普段のモデル・設定・利用枠で、どこまで進むかを記録。
同じモデルで推論・出力・実行予算を広げ、改善するかを確認。
同じ課題・RAG・ツール条件で、完了度と必要工数を測定。
完了率 / 未発見の不具合 / 回帰テスト / 人の手戻り / 所要時間 / 総費用
比較計画の提案です。Bはサービスが設定変更を許す範囲で評価します。異なるモデルではモデル能力の差も含まれるため、RAGと計算予算の効果は条件を分けて確認します。
LMRは、自社の計算設備と開発案件を持つ研究所です。そこで得た運用の勘所を、導入先の業務へ。機器・ソフト・知識基盤を、ひとつの開発環境として設計します。
解決したいタスクと合格条件を揃える。
GPU・モデル・RAG・ツールを組み合わせる。
使い方、保守、更新と評価の運用を整える。
性能は対象業務、モデル、推論設定、RAG、ツール、実行予算によって変わります。このページの表現はLMRの自社運用での実感に基づきます。導入先の実案件で、完了率と必要な工数を比較します。
自社で動かすローカルモデルの推論には、クラウドAPIのトークン従量課金はありません。設備・電力・保守・運用の費用はかかります。外部APIや別の有料サービスを組み合わせる場合は、それぞれの料金が発生します。
適用条件・根拠・機密区分などを整理し、現在の案件に合った知識をRAGで検索する構成を検討します。知識の鮮度と品質を管理し、実行・検証の結果で更新することが重要です。
ランチャー、IDE、CLIなどの操作環境とローカル推論APIをつなぐ構成を設計します。モデル接続の互換性や各ソフトの利用条件は個別に確認し、必要に応じて実行層を選び直します。
対象モデル、量子化、文脈長、同時利用数、応答速度、連続実行する処理から設計します。掲載のB300構成はLMRの運用例で、すべてのお客様に同じ機器を求めるものではありません。
いま止まっている案件を、ひとつ持ち込んでください。
ローカルAIが、その仕事をどこまで前へ進められるか。
実際のタスクを基準に、一緒に確かめます。
導入相談で伺うこと:開発したいもの / 現在困っている点 / 利用人数 / 社内に置きたいデータ / 既存の計算設備
本ページは「LMR ローカルAI開発基盤 Webページ案・改訂版」(2026年11月16日)の内容を基にしています。運用経験、公開仕様、条件付きの考察、開発提案を区別して掲載しています。
元PDFの公式資料確認日:2026年11月16日。共有推論の技術的背景や推論量の調整を説明する資料であり、特定事業者のGPU割当量や、意図的にタスクを未完成にする運用の証明ではありません。